Inferenza LLM
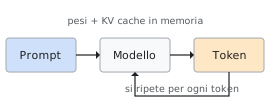
Il ciclo autoregressivo: ogni token generato rientra come input.
Definizione Uso di un modello già addestrato per generare testo Unità di base Token (≈ ¾ di parola in inglese) Fasi Prefill, decode Collo di bottiglia Banda di memoria (nella fase di decode) Tecniche chiave KV cache, batching, quantizzazione Metriche TTFT, TPOT, throughput Software tipici vLLM, TensorRT-LLM, llama.cpp, Hugging Face TGI Hardware GPU, TPU, acceleratori dedicati
L’inferenza di un modello linguistico di grandi dimensioni (in inglese Large Language Model inference, abbreviato LLM inference) è il processo con cui un modello già addestrato riceve un testo in ingresso, detto prompt, e produce un testo in uscita. Si distingue dall’addestramento (training), che è la fase in cui il modello impara i propri parametri: durante l’inferenza i parametri restano fissi e vengono soltanto usati.
L’inferenza rappresenta la maggior parte del costo di esercizio di un LLM in produzione, perché un modello viene addestrato una volta ma interrogato milioni di volte. Per questo motivo la sua ottimizzazione è un settore dell’ingegneria a sé stante, che si occupa di ridurre la latenza, aumentare il numero di richieste servite e contenere l’uso di memoria. Le tecniche principali sono la KV cache, il batching e la quantizzazione.
Generazione autoregressiva
Gli LLM moderni, basati sull’architettura Transformer,1 generano il testo in modo autoregressivo: producono un token alla volta e ogni nuovo token dipende da tutti quelli che lo precedono. Il procedimento è il seguente:
- il modello riceve la sequenza di token disponibile (il prompt più quanto già generato);
- calcola, per ogni token del vocabolario, un punteggio chiamato logit, che viene trasformato in una probabilità;
- sceglie il token successivo in base a queste probabilità;
- aggiunge il token scelto alla sequenza e ricomincia dal punto 1.
Il ciclo si ferma quando il modello produce un token speciale di fine sequenza oppure quando si raggiunge il numero massimo di token stabilito.
Token e tokenizzazione
Un token è l’unità minima di testo che il modello elabora. Non coincide con una parola: può essere una parola intera, una sua parte o un segno di punteggiatura. La suddivisione del testo in token si chiama tokenizzazione e di solito usa algoritmi come il Byte Pair Encoding (BPE). In inglese un token corrisponde in media a circa tre quarti di parola; in italiano, che è meno presente nei dati di addestramento, una stessa frase richiede spesso più token.
Scelta del token successivo
La regola con cui si sceglie il token prende il nome di strategia di decodifica o di campionamento:
- Greedy: si prende sempre il token più probabile. È deterministica ma tende a produrre testo ripetitivo.
- Temperatura: un parametro che rende la distribuzione più “piatta” (valori alti, testo più vario) o più “appuntita” (valori bassi, testo più prevedibile).
- Top-k: si campiona solo tra i k token più probabili.
- Top-p (o nucleus sampling): si campiona tra i token più probabili la cui probabilità cumulata raggiunge la soglia p.
Fasi dell’inferenza
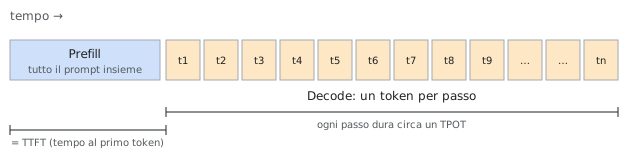
Figura 1. Andamento temporale di una richiesta: un unico passo di prefill, poi tanti passi di decode, uno per ogni token generato.
L’inferenza di una singola richiesta si divide in due fasi con caratteristiche molto diverse. Molte ottimizzazioni si capiscono solo tenendo presente questa distinzione.
Prefill
Nella fase di prefill (detta anche prompt processing) il modello legge l’intero prompt in un solo passaggio. Poiché tutti i token del prompt sono già noti, possono essere elaborati in parallelo con grandi moltiplicazioni tra matrici. Questa fase è quindi limitata dalla potenza di calcolo (compute-bound) e sfrutta bene l’hardware. Al termine del prefill il modello produce il primo token della risposta e riempie la KV cache con i dati del prompt.
Decode
Nella fase di decode (o generation) il modello genera i token successivi uno alla volta, perché ciascuno dipende dal precedente. A ogni passo elabora un solo nuovo token, ma deve comunque leggere dalla memoria tutti i pesi del modello e la KV cache. Il calcolo da fare è poco rispetto ai dati da spostare, per cui questa fase è limitata dalla banda di memoria (memory-bound; vedi sotto). Il decode occupa di solito la maggior parte del tempo totale di una richiesta.
Confronto tra le due fasi
| Caratteristica | Prefill | Decode |
|---|---|---|
| Token elaborati per passo | Tutti quelli del prompt | Uno |
| Parallelismo | Alto | Basso (sequenziale) |
| Risorsa limitante | Calcolo | Banda di memoria |
| Metrica collegata | TTFT | TPOT |
Memoria
La memoria dell’acceleratore (per esempio la VRAM di una GPU) è la risorsa più scarsa durante l’inferenza. Viene occupata principalmente da due elementi: i pesi del modello e la KV cache.
Pesi del modello
I pesi sono i parametri appresi durante l’addestramento. La memoria che occupano si calcola con una formula semplice:
Il numero di byte dipende dal formato numerico usato (vedi Quantizzazione).
Memoria occupata dai soli pesi di un modello da 7 miliardi di parametri
| Formato | Byte per parametro | Memoria |
|---|---|---|
| FP32 | 4 | ≈ 28 GB |
| FP16 / BF16 | 2 | ≈ 14 GB |
| INT8 | 1 | ≈ 7 GB |
| INT4 | 0,5 | ≈ 3,5 GB |
KV cache
Nel meccanismo di attention del Transformer, ogni token produce due vettori chiamati chiave (key, K) e valore (value, V), che i token successivi usano per “guardare” il passato. Senza accorgimenti, a ogni passo di decode il modello dovrebbe ricalcolare K e V per tutti i token precedenti, ripetendo un lavoro già fatto.
La KV cache evita questo spreco: salva in memoria K e V di ogni token già elaborato, così a ogni passo si calcolano solo quelli del nuovo token. È una classica scelta tra memoria e calcolo: si usa più memoria per fare molti meno calcoli.
La sua dimensione cresce in modo lineare con la lunghezza del testo e con il numero di richieste servite insieme:
(il 2 conta sia K sia V)
Esempio. Per un modello con 32 layer e dimensione 4096 in FP16 (2 byte), come Llama 2 7B, ogni token occupa 2 × 32 × 4096 × 2 = 524 288 byte, cioè circa 0,5 MB. Una conversazione di 4096 token richiede circa 2 GB di KV cache; 8 conversazioni di quella lunghezza servite insieme ne richiedono circa 16 GB, più dei pesi stessi.
Per questo la KV cache è spesso ciò che limita quante richieste si possono servire contemporaneamente. Alcune soluzioni:
- PagedAttention, introdotta con il sistema vLLM: gestisce la KV cache in blocchi di dimensione fissa, come la memoria virtuale di un sistema operativo, riducendo lo spreco dovuto alla frammentazione.2
- Grouped-Query Attention (GQA) e Multi-Query Attention (MQA): varianti dell’architettura in cui più “teste” di attention condividono le stesse K e V, riducendo la cache.3
- Quantizzazione della KV cache: si salvano K e V con meno bit.
Limite della banda di memoria
Questa è l’idea più importante della voce: spiega perché esistono quasi tutte le altre tecniche.
Un acceleratore ha due capacità distinte: quante operazioni può fare al secondo (potenza di calcolo, misurata in FLOPS) e quanti dati può leggere dalla memoria al secondo (banda di memoria, misurata in GB/s). Un’operazione è compute-bound se è limitata dalla prima, memory-bound se è limitata dalla seconda.
Il rapporto tra operazioni eseguite e byte letti si chiama intensità aritmetica. Nel decode con una sola richiesta, per ogni parametro letto (2 byte in FP16) si fanno circa 2 operazioni: l’intensità è circa 1 operazione per byte. Le GPU moderne, invece, per essere sfruttate a pieno hanno bisogno di centinaia di operazioni per byte. Il risultato è che, nel decode, l’unità di calcolo passa la maggior parte del tempo ad aspettare i dati.
Da qui si ricava un limite superiore alla velocità di generazione di una singola richiesta:
Esempio. Un modello da 14 GB (7B in FP16) su un acceleratore con banda di 1 000 GB/s non può superare circa 1 000 ÷ 14 ≈ 70 token al secondo per singola richiesta, qualunque sia la sua potenza di calcolo.
Le tecniche di ottimizzazione agiscono su questo limite in due modi:
- leggere meno byte: è lo scopo della quantizzazione;
- fare più lavoro per ogni lettura: è lo scopo del batching, perché i pesi letti una volta servono a più richieste.
Batching
Il batching consiste nell’elaborare più richieste insieme in un unico passaggio del modello. Poiché nel decode il costo principale è leggere i pesi, servire 16 richieste insieme costa poco più che servirne una: i pesi vengono letti una sola volta e usati per tutte. Il throughput complessivo, cioè i token generati al secondo sommando tutti gli utenti, aumenta quindi di molto.
Esistono diverse forme di batching:
- Batching statico: si raccoglie un gruppo di richieste e lo si elabora fino a quando tutte sono terminate. È semplice, ma una risposta lunga costringe le altre, già finite, ad aspettare, e i posti liberi restano inutilizzati.
- Batching dinamico: il gruppo si forma raccogliendo le richieste che arrivano entro una breve finestra di tempo. Riduce l’attesa per formare il gruppo, ma ha gli stessi limiti del precedente una volta avviato.
- Continuous batching (o in-flight batching, iteration-level scheduling): la composizione del gruppo viene aggiornata a ogni passo di decode. Appena una richiesta finisce, il suo posto viene preso da una nuova. L’hardware resta sempre occupato. È la tecnica usata dai principali sistemi di serving moderni.4
Compromesso latenza–throughput. Batch più grandi aumentano il throughput totale ma rendono ogni passo un po’ più lento, quindi ogni singolo utente riceve i token leggermente più tardi. Inoltre ogni richiesta in più occupa spazio nella KV cache. La dimensione del batch si sceglie bilanciando questi tre fattori.
Quantizzazione
La quantizzazione è la rappresentazione dei pesi (e talvolta delle attivazioni e della KV cache) con numeri a precisione ridotta, cioè con meno bit. I modelli vengono di solito addestrati in FP32 o BF16 e poi convertiti, per l’inferenza, in formati come INT8 o INT4.
I vantaggi sono due: il modello occupa meno memoria (ci sta su hardware più piccolo, o lascia più spazio alla KV cache) e, siccome il decode è memory-bound, genera più velocemente, perché a ogni passo legge meno byte. Lo svantaggio è una perdita di accuratezza, di solito piccola a 8 bit e più evidente a 4 bit o meno.
Formati numerici comuni
| Formato | Bit | Tipo | Uso tipico |
|---|---|---|---|
| FP32 | 32 | Virgola mobile | Addestramento (storico) |
| BF16 | 16 | Virgola mobile | Addestramento e inferenza |
| FP16 | 16 | Virgola mobile | Inferenza |
| FP8 | 8 | Virgola mobile | Inferenza su hardware recente |
| INT8 | 8 | Intero | Inferenza |
| INT4 | 4 | Intero | Inferenza su hardware limitato |
Classificazione
- In base a quando avviene:
- Post-Training Quantization (PTQ): si quantizza un modello già addestrato. È la forma più comune perché non richiede di riaddestrare.
- Quantization-Aware Training (QAT): il modello viene addestrato “sapendo” che sarà quantizzato, così perde meno qualità.
- In base a cosa si quantizza:
- Solo pesi (weight-only): si riduce la memoria, ma i calcoli avvengono ancora ad alta precisione.
- Pesi e attivazioni: anche i calcoli avvengono a bassa precisione, se l’hardware lo supporta.
Tra i metodi più noti figurano LLM.int8(),5 GPTQ6 e AWQ.7
Metriche di prestazione
Le prestazioni di un sistema di inferenza si misurano con poche metriche standard:
| Sigla | Nome inglese | Significato | Dipende soprattutto da |
|---|---|---|---|
| TTFT | Time To First Token | Tempo tra l’invio della richiesta e l’arrivo del primo token | Prefill, coda di attesa |
| TPOT / ITL | Time Per Output Token / Inter-Token Latency | Tempo medio tra un token e il successivo | Decode, dimensione del batch |
| Latenza | End-to-end latency | Tempo totale per avere la risposta completa | Entrambe le fasi |
| Throughput | Throughput | Token (o richieste) prodotti al secondo dall’intero sistema | Batching, hardware |
La latenza totale di una risposta di n token si può approssimare così:
Il TTFT conta soprattutto nelle applicazioni interattive come le chat, perché è il momento in cui l’utente vede la risposta “iniziare”. Il throughput conta soprattutto per i costi: più token al secondo significa servire più utenti con lo stesso hardware. Quando si confrontano due configurazioni, si guardano di solito anche i valori di coda, come il 95° o il 99° percentile (p95, p99), e non solo la media.
Altre tecniche di ottimizzazione
- FlashAttention: un’implementazione dell’attention che riorganizza i calcoli per ridurre le letture e scritture nella memoria principale, rendendo il calcolo più veloce senza cambiarne il risultato.8
- Speculative decoding: un modello piccolo e veloce “indovina” diversi token in anticipo, e il modello grande li verifica tutti insieme in un solo passo. Se le ipotesi sono corrette, si generano più token per passo.9
- Parallelismo: quando un modello non entra in un solo acceleratore, lo si divide tra più dispositivi. Nel tensor parallelism ogni layer viene diviso tra i dispositivi; nel pipeline parallelism ogni dispositivo esegue un gruppo di layer.
- Prefix caching: se molte richieste iniziano con lo stesso testo (per esempio lo stesso prompt di sistema), la KV cache di quella parte comune viene calcolata una volta e riutilizzata.
- Chunked prefill: i prompt molto lunghi vengono divisi in pezzi e alternati con i passi di decode di altre richieste, per evitare che un prompt lungo blocchi tutti gli altri utenti.
Hardware
L’inferenza degli LLM avviene di solito su acceleratori, cioè processori specializzati in calcoli paralleli su matrici. Le caratteristiche che contano di più sono la quantità di memoria (quanto grande può essere il modello più la KV cache), la banda di memoria (quanto veloce è il decode) e il supporto a formati a bassa precisione (quanto si guadagna dalla quantizzazione).
- GPU: gli acceleratori più diffusi, in particolare quelli di NVIDIA, usati con software come vLLM e TensorRT-LLM.
- TPU: acceleratori progettati da Google per l’apprendimento automatico.
- Acceleratori dedicati: chip progettati da altre aziende per l’inferenza. Tra questi c’è IBM Spyre, una scheda PCIe pensata per eseguire modelli di AI, compresi gli LLM, sui mainframe IBM Z e sui sistemi LinuxONE, vicino ai dati delle aziende.10 Su questi dispositivi si applicano gli stessi principi descritti in questa voce: gestione della memoria, batching, quantizzazione e misura delle prestazioni.
Glossario inglese–italiano
Termini usati comunemente in inglese anche nei contesti italiani, con una frase di esempio utile in un colloquio di lavoro.
| Termine | Significato | Frase di esempio |
|---|---|---|
| Inference | Uso del modello addestrato | Inference is when we use a trained model to generate output. |
| Autoregressive | Un token alla volta, ognuno dipende dai precedenti | An LLM generates text one token at a time. |
| Prefill / decode | Lettura del prompt / generazione della risposta | Prefill reads the prompt in parallel; decode generates tokens one by one. |
| KV cache | Memoria di K e V dei token passati | The KV cache stores past keys and values, so we don’t recompute them. |
| Memory-bound | Limitato dalla banda di memoria | Decode is memory-bound: for each token we read all the weights. |
| Batching | Elaborare più richieste insieme | Batching uses the weights for many requests at once. |
| Continuous batching | Il batch cambia a ogni passo | New requests join as soon as others finish. |
| Quantization | Numeri con meno bit | Quantization makes the model smaller and faster, with a small loss in quality. |
| TTFT | Tempo al primo token | TTFT is how long the user waits before the answer starts. |
| Throughput | Token al secondo dell’intero sistema | Bigger batches give higher throughput but higher latency per user. |
| Profiling | Misurare dove si spende il tempo | I profile the system to find where time is spent. |
Voci correlate
- Transformer (architettura)
- Meccanismo di attention
- Retrieval-Augmented Generation
- Unità di elaborazione grafica (GPU)
- Modello roofline
- Memoria virtuale
- Addestramento di reti neurali
- Distillazione della conoscenza
Note
Footnotes
-
Vaswani, A. et al. (2017). Attention Is All You Need. NeurIPS. arXiv:1706.03762 ↩
-
Kwon, W. et al. (2023). Efficient Memory Management for Large Language Model Serving with PagedAttention. SOSP. arXiv:2309.06180 ↩
-
Ainslie, J. et al. (2023). GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints. EMNLP. arXiv:2305.13245 ↩
-
Yu, G.-I. et al. (2022). Orca: A Distributed Serving System for Transformer-Based Generative Models. OSDI. usenix.org ↩
-
Dettmers, T. et al. (2022). LLM.int8(): 8-bit Matrix Multiplication for Transformers at Scale. NeurIPS. arXiv:2208.07339 ↩
-
Frantar, E. et al. (2022). GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers. ICLR 2023. arXiv:2210.17323 ↩
-
Lin, J. et al. (2023). AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration. MLSys 2024. arXiv:2306.00978 ↩
-
Dao, T. et al. (2022). FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness. NeurIPS. arXiv:2205.14135 ↩
-
Leviathan, Y., Kalman, M., Matias, Y. (2023). Fast Inference from Transformers via Speculative Decoding. ICML. arXiv:2211.17192 ↩
-
IBM. Pagine di prodotto su IBM Spyre Accelerator e IBM z17. Le specifiche tecniche vanno verificate sulla documentazione ufficiale IBM: ibm.com ↩